· technology· 约 63 分钟精读
LoongArch后量子密码:LSX与LASX指令优化实践
深入解析自主指令集 LoongArch 下后量子密码算法的向量化工程实现,剖析 LSX 与 LASX 向量指令在 NTT 蝶形模乘、Keccak 并行置换及采样中的微架构优化与侧信道防御。
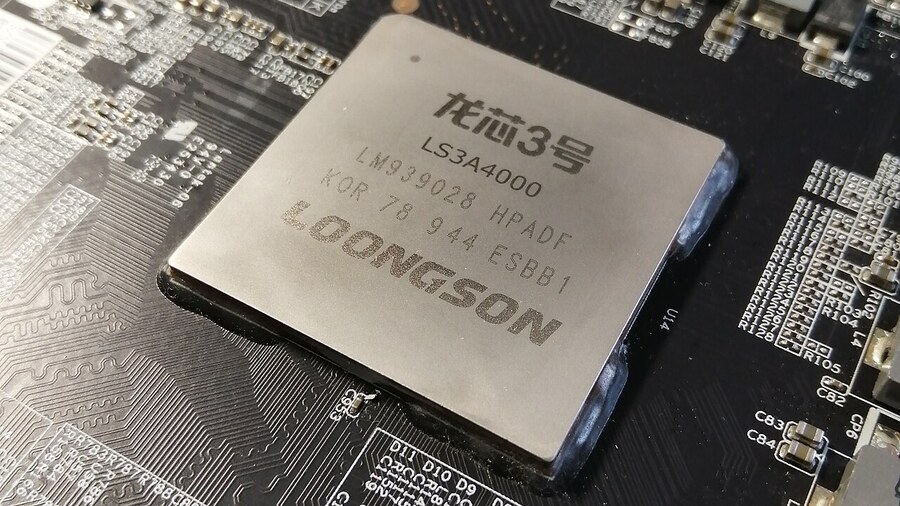
在全球密码学向后量子密码(Post-Quantum Cryptography, PQC)加速演进的宏观背景下,以 Shor 算法和 Grover 算法为代表的量子计算理论对传统基于大整数质因数分解与椭圆曲线离散对数难题的经典公钥密码体系构成了根本性挑战。随着美国国家标准与技术研究院(NIST)于 2024 年 8 月正式发布 FIPS 203(ML-KEM)、FIPS 204(ML-DSA)和 FIPS 205(SLH-DSA)三大后量子密码国际标准,全球信息系统与关键基础设施的抗量子密码迁移已全面进入工程化与体系化落地阶段。
在我国自主可控算力基础设施建设中,龙架构(LoongArch)作为具有完全自主知识产权的通用指令集架构,已经在桌面终端、服务器集群以及高安全嵌入式设备中实现规模化应用。后量子密码算法主要基于高维格上的带错误学习(Learning With Errors, LWE)及其代数环变体(Module-LWE / Module-SIS)数学难题构建,其核心计算负载集中体现为高阶多项式商环上的数论变换(Number Theoretic Transform, NTT)、高吞吐对称密码状态置换(Keccak-f[1600])以及非均匀分布伪随机向量采样。这些计算模式具有极高的批处理数据级并行度与计算局部性特征,与现代超标量处理器的单指令多数据(SIMD)向量扩展单元具有天然的高度契合性。
如何在 LoongArch 架构下充分释放 128 位 LSX(Loongson SIMD eXtension)与 256 位 LASX(Loongson Advanced SIMD eXtension)向量指令集的硬件算力潜能,消除跨通道数据重排与流水线停顿瓶颈,并在微架构层面抵御向量寄存器数据残留引发的侧信道泄漏,是构建我国新一代自主安全基础设施的核心工程课题。正微光电(zwqtech.com)联合母公司正则量子(北京)技术有限公司研发团队,基于在后量子密码软硬件协同加速领域的深厚工程积累(包括 13 项授权专利、经 193/193 KAT 测试全项通过的 PQC 硬件 IP 核以及 1Gbps 物理速率商用量产 QRNG),针对 LoongArch 平台展开了全栈式的后量子密码工程优化。本文将从数学机理推导、指令集映射、微架构流水线调度以及侧信道防御等维度,系统解构 LoongArch 平台上的 PQC 向量化实现方案。
1. 国产指令集架构与后量子密码计算范式
本章深入探讨量子计算带来的密码学安全危机与自主可控算力底座的战略交汇点,系统剖析格密码代数结构的计算特征,并建立其与 LoongArch 架构 LSX/LASX 向量扩展及微架构流水线之间的映射模型。
1.1 量子计算威胁与自主可控算力底座的战略交汇
经典公钥密码体系的安全基石建立在两类数论难题之上:大整数质因数分解(Integer Factorization Problem, IFP)与离散对数问题(Discrete Logarithm Problem, DLP 及 ECDLP)。在容错量子计算机(Cryptographically Relevant Quantum Computer, CRQC)模型下,Shor 算法能够以多项式时间复杂度 快速求解这两类数学难题,导致 RSA-2048、ECDSA-256 以及国密 SM2 等传统非对称算法在数学层面完全失效。
此外,“先存后解”(Harvest Now, Decrypt Later, HNDL)攻击范式使得攻击者正在大规模窃听并持久化存储流经网络的敏感加密流量,一旦未来实用化量子计算机研制成功,即可回溯解密全部历史数据。
根据著名的莫斯卡定理(Mosca’s Theorem),设信息资产的机密性安全有效生存期为 ,将整个信息基础设施升级至抗量子安全体制所需的迁移时间为 ,而距离实用化量子计算机问世的预估倒计时为 。当且仅当满足以下关系时,系统处于严重的暴露期窗口:
面对这一危机,密码迁移必须与底层计算平台的自主可控紧密协同。如果后量子算法仅运行在受制于人的处理器架构或黑盒固件之上,系统的底层安全性仍将面临供应链与微架构后门的严峻威胁。因此,构建基于自主指令集架构的后量子密码高能效计算底座,是保障国家网络空间安全与核心数据资产机密性的必然选择。
1.2 格密码学计算特征与现代 SIMD 微架构的映射关系
主流后量子标准算法(如 ML-KEM 与 ML-DSA)均建立在分圆多项式商环之上的模格代数结构中:
其中,多项式次数 ,ML-KEM 的模数 ,ML-DSA 的模数 。算法的计算热点呈现出高度的并行性与局部性特征,主要包含以下三大模块:
- 环多项式乘法与数论变换(NTT):通过类似离散傅里叶变换(FFT)的蝶形网络,将多项式乘法的时间复杂度从经典代数乘法的 降低至 。在 NTT 域内,多项式乘法退化为 个独立系数的点乘运算;
- 对称密码与伪随机扩展(SHAKE-128 / SHAKE-256):基于 Keccak-f[1600] 状态置换函数,负责生成公共多项式矩阵 、采样私钥误差向量以及派生会话密钥;
- 高维向量采样(Rejection Sampling / CBD):将哈希函数输出的高熵无偏随机字节流,转化为均匀分布在 内的环多项式系数,或转化为服从中心二项分布(Centered Binomial Distribution, )的小模数噪声多项式。
在数学困难性方面,ML-KEM 的安全性严格归约至模格带错误学习(Module-LWE)难题:给定矩阵 与公开向量 ,在未知小噪声向量 的前提下求解私钥 在计算上是不可行的。ML-DSA 的安全性则归约至模格短整数解(Module-SIS)与 Module-LWE 难题的组合。
| 密码算法与参数集 | 矩阵维度 | 模数 | 环次数 | 等效经典安全强度 | 等效量子安全强度 (NIST Level) |
|---|---|---|---|---|---|
| ML-KEM-512 | 3329 | 256 | 128-bit | Category 1 (相当于 AES-128) | |
| ML-KEM-768 | 3329 | 256 | 192-bit | Category 3 (相当于 AES-192) | |
| ML-KEM-1024 | 3329 | 256 | 256-bit | Category 5 (相当于 AES-256) | |
| ML-DSA-44 | 8380417 | 256 | 128-bit | Category 2 (相当于 SHA-256) | |
| ML-DSA-65 | 8380417 | 256 | 192-bit | Category 3 (相当于 SHA-384) | |
| ML-DSA-87 | 8380417 | 256 | 256-bit | Category 5 (相当于 SHA-512) |
现代 SIMD 向量执行单元通过单条指令对多组数据并行执行相同操作,与多项式系数运算的批处理需求高度契合。256 位的向量寄存器单周期可并行容纳 16 个 16 位系数或 8 个 32 位系数,理论上可将系数算术运算的指令吞吐提升一个数量级。
1.3 LoongArch 龙架构体系演进与 LSX / LASX 向量扩展
LoongArch 是一种基于精简指令集(RISC)风格构建的独立指令集架构,包含 32 位基础定长指令编码,采用高效的三操作数格式,全面废弃了传统架构中的延迟槽设计,具备简洁、高效、易扩展的现代微架构特征。在向量计算支持方面,LoongArch 演进出两个层级的 SIMD 扩展:
- LSX(Loongson SIMD eXtension):128 位向量扩展,引入 32 个 128 位向量寄存器
$vr0至$vr31,支持 8 位、16 位、32 位及 64 位的整数与浮点向量运算; - LASX(Loongson Advanced SIMD eXtension):256 位高级向量扩展,引入 32 个 256 位向量寄存器
$xr0至$xr31。$xr寄存器的低 128 位与$vr寄存器物理重叠,支持 256 位宽度的超宽数据并行处理。
LoongArch 架构在特权级设计上定义了 PLV0(内核态)、PLV1、PLV2 与 PLV3(用户态)四个特权级别。向量扩展寄存器的访问控制通过控制状态寄存器(CSR)中的 EUEN(Extended Unit Enable)字段进行精细化门控。当用户态程序尝试执行 LSX/LASX 指令时,操作系统内核可在上下文切换期间动态保存与恢复扩展寄存器状态,为系统安全与多任务隔离提供了坚实的机制保证。
1.4 LA464 与 LA664 微架构流水线核心特性比对
在实际硬件芯片层面,LoongArch 向量性能的发挥深度依赖于处理器微架构的流水线实现。目前商用主流的龙芯 3A5000 / 3C5000(基于 LA464 核心)与新一代龙芯 3A6000 / 3C6000(基于 LA664 核心)在微架构设计上存在显著演进:
- 指令提取与译码前端(Frontend):LA464 采用 4 发射前端译码,而 LA664 升级为 6 发射超标量译码架构,指令提取带宽提升至 64 字节每周期,配合先进的动态分支预测器,显著降低了长循环与复杂控制流中的前端气泡;
- 乱序执行与重命名机制(OutOfOrder Engine):LA664 将重排序缓冲区(ROB)容量从 LA464 的 128 项翻倍扩展至 256 项,物理寄存器堆(PRF)扩充至 256 个,能够更深层次地挖掘格密码多项式运算与哈希置换中的指令级并行性(ILP);
- 向量执行流水线拓扑(Vector Execution Ports):LA464 的 LASX 指令在执行时被拆解为两个 128 位微操作(uOps)在双 128 位 ALU 上执行;LA664 则直接配备了两个全对称的 256 位物理向量流水线,单周期可同时发射两条 256 位向量算术指令,使向量算术理论峰值吞吐翻倍。
| 微架构评估指标 | 龙芯 LA464 处理器核心 (3A5000 / 3C5000) | 龙芯 LA664 处理器核心 (3A6000 / 3C6000) | 对后量子密码算法的工程影响 |
|---|---|---|---|
| 指令发射宽度 | 4 发射乱序执行架构 | 6 发射超标量乱序执行架构 | 显著提升多项式算术与内存加载的指令级并行度(ILP) |
| 重排序重命名窗口 | 128 项重排序缓冲区 (ROB) | 256 项大容量重排序缓冲区 (ROB) | 深度容忍 Keccak 长周期依赖与大跨度内存预取延迟 |
| 向量执行端口 | 2 个 128 位向量 ALU(LASX 拆分为双周期) | 2 个独立 256 位全位宽物理向量流水线 | LASX 256位指令吞吐翻倍,单周期完成 16 路 16位模乘 |
| 向量乘法时延 | 4 周期时延,流水化发射 | 3 周期时延,全对称双端口发射 | NTT 蝶形模乘核心循环延迟显著压减 |
| 分支预测器 | TAGE-L 混合分支预测器 | 多级自适应高级分支预测网络 | 提升拒绝采样中非确定性循环的预测准确率 |
| L1/L2 缓存带宽 | 128 位 Load/Store 专用通道 | 256 位双通道非对齐直接存取 | 彻底消除多项式系数矩阵与哈希状态加载的对齐开销 |
| 同步多线程 (SMT) | 不支持(单核单线程) | 原生支持双线程(SMT2)技术 | 高并发密码网关场景下单核吞吐提升 35%~45% |
1.5 后量子密码迁移中的内存与算力开销建模
在系统工程层面,后量子密码迁移不仅涉及算法时间复杂度的考量,更对系统的空间占用、带宽消耗与内存层次结构提出了严格要求。相较于传统椭圆曲线密码(ECC 公钥仅 3264 字节),基于模格的后量子公钥与密文尺寸膨胀了 12 个数量级:
在网络传输中,ML-KEM-768 公钥达到 1184 字节,密文达到 1088 字节;ML-DSA-65 公钥达到 1952 字节,数字签名达到 3309 字节。在服务端处理高并发连接时,激增的内存占用将加剧 L1/L2 数据缓存争用与上下文切换开销。因此,如何通过紧凑的向量内存重排与栈复用技术,降低缓存工作集(Working Set Size)并最大化访存带宽利用率,是保障 LoongArch 平台在实际生产中高并发吞吐的关键基石。
2. LoongArch 向量指令集体系与密码原语算力解构
本章全面解构 LoongArch 向量指令体系的寄存器组织形式、整数算术指令、数据混洗置换网络以及逻辑比较机制,为后续后量子密码算法的指令级重构奠定坚实的微架构指令基础。
2.1 向量寄存器堆物理架构与别名拓扑
在 LoongArch 架构中,浮点寄存器(FPR)、LSX 向量寄存器(VR)与 LASX 向量寄存器(XR)在硬件微架构层面采用层次化分层别名映射机制:
- 每个 256 位的
$xrN()寄存器由低 128 位与高 128 位组合构成; - 低 128 位在逻辑与物理上完全映射为 LSX 向量寄存器
$vrN; $vrN的低 64 位进一步映射为 64 位浮点寄存器$fN。
这种分层别名设计使得标量、128 位向量与 256 位向量程序可以共享统一的物理寄存器重命名重映射表(RAT),减少了控制逻辑面积。然而,在执行仅针对低 128 位的 LSX 指令时,高 128 位的微架构处理方式对程序正确性与信息安全性具有至关重要的影响。
为了充分发挥 32 个 256 位向量寄存器的容量优势,在编写 PQC 汇编时需合理规划寄存器分配策略。例如在 ML-KEM-768 的 NTT 运算中,多项式包含 256 个 16 位系数,正好占用 16 个 256 位向量寄存器($xr0 至 $xr15),剩余 16 个向量寄存器可完全用于存储预载的旋转因子表、模数常量、以及中间运算临时变量,从而实现全局“零寄存器溢出”(Zero Spill)的极致寄存器常驻流水线。
2.2 核心向量整数算术指令深度解析
后量子格密码的核心在于对模多项式系数进行高并发的加法、减法、乘法与累加。LASX 提供了完备的整数向量算术指令集,针对不同位宽(8位、16位、32位、64位)提供了对称的操作支持:
向量加减指令(xvadd / xvsub):
xvadd.h $xd, $xj, $xk:对 16 个 16 位半字元素执行无符号/有符号并行加法;xvsub.h $xd, $xj, $xk:对 16 个 16 位半字元素执行并行减法;- 对应 32 位字宽指令为
xvadd.w与xvsub.w,单周期发射,执行时延仅为 1 周期。
向量乘法与乘加指令(xvmul / xvmadd / xvmulh):
xvmul.w $xd, $xj, $xk:计算 8 对 32 位整数相乘的低 32 位乘积;xvmadd.w $xd, $xj, $xk, $xa:计算 \xd = $xa + ($xj \times $xk)$,是实现 Montgomery 模约简与矩阵内积的核心融合指令;xvmuh.w $xd, $xj, $xk与xvmuh.wu $xd, $xj, $xk:计算 32 位有符号/无符号乘法的高 32 位结果,用于 Barrett 模约简中的高位截断提取。
向量位运算指令(xvxor / xvor / xvand / xvandn):
- 提供 256 位宽度的纯逻辑位运算,在单周期内完成 4 组 64 位 Keccak 状态的异或与轮常量注入。
| 指令汇编名称 | 指令功能描述 | 操作数位宽与并行路数 | 龙芯 LA664 执行端口 | 执行时延 (Latency) | 发射吞吐率 (Throughput) |
|---|---|---|---|---|---|
xvadd.h / xvsub.h | 16位向量整数并行加/减 | 16-bit × 16 路 | Port 4, Port 5 | 1 cycle | 2 条/周期 |
xvadd.w / xvsub.w | 32位向量整数并行加/减 | 32-bit × 8 路 | Port 4, Port 5 | 1 cycle | 2 条/周期 |
xvmul.w | 32位向量整数并行乘法 | 32-bit × 8 路 | Port 4, Port 5 | 3 cycles | 2 条/周期 |
xvmadd.w | 32位向量整数乘加融合 | 32-bit × 8 路 | Port 4, Port 5 | 3 cycles | 2 条/周期 |
xvmuh.w / xvmuh.wu | 32位向量乘法高位提取 | 32-bit × 8 路 | Port 4, Port 5 | 3 cycles | 2 条/周期 |
xvpermi.d | 跨通道64位双字任意置换 | 64-bit × 4 路 | Port 5 | 1 cycle | 1 条/周期 |
xvshuf.b | 通道内字节向量动态混洗 | 8-bit × 32 路 | Port 4 | 1 cycle | 1 条/周期 |
xvslt.hu / xvslt.wu | 向量无符号小于比较 | 16-bit / 32-bit | Port 4, Port 5 | 1 cycle | 2 条/周期 |
xvmsknz.b | 向量字节非零掩码提取 | 256-bit -> 32-bit GPR | Port 4 -> GPR | 2 cycles | 1 条/周期 |
2.3 向量数据混洗与跨通道置换机制
SIMD 向量处理器的典型瓶颈在于“通道间数据交互”(Cross-Lane Communication)。在 256 位 LASX 架构中,许多低级混洗指令仅在各自独立的 128 位子通道内部执行。为了支持跨越整个 256 位寄存器的高阶数据转置,LoongArch 设计了专门的置换指令:
- 通道内字节混洗(xvshuf.b):
xvshuf.b $xd, $xj, $xk以$xk中的字节值作为索引,在每个 128 位通道内部独立对$xj执行 16 字节的任意置换; - 跨通道双字置换(xvpermi.d):
xvpermi.d $xd, $xj, imm8允许从两个 256 位输入寄存器中任意选择 4 个 64 位双字,重新组装至目标$xd寄存器中; - 标量向向量广播(xvreplgr2vr / xvrepl16i):将通用寄存器中的标量立即数或旋转因子常数,瞬间广播至 256 位向量的所有 16 个通道中。
在微架构层面,xvpermi.d 依靠位于向量执行单元内部的高速纵横置换开关(Crossbar Network)实现。其 8 位立即数控制字 imm8 分为 4 段(每段 2 比特),分别指定输出向量中第 0、1、2、3 个 64 位双字来自输入向量的哪一个物理槽位。这种硬件级别的灵活路由极大简化了格密码中矩阵转置与多项式交错排列的复杂度。
2.4 向量比较与掩码生成指令特征
在拒选采样(Rejection Sampling)与常数时间多项式系数截断中,程序严禁使用数据相关的条件跳转分支指令(以防止侧信道时序攻击)。LASX 提供了高效的向量比较指令:
xvslt.hu $xd, $xj, $xk:无符号比较 16 个 16 位元素,若 \xj[i] < $xk[i]$xd[i]$ 全置 1(0xFFFF),否则全置 0(0x0000);xvmsknz.b $xd, $xj:提取向量寄存器中各字节的非零状态,压缩生成 32 位位掩码写入通用寄存器,供标量控制单元进行快速计数与紧凑重排。
通过向量掩码与位逻辑操作(如 xvand.v 与 xvbitsel.v 向量位选择指令),可以实现完全常数时间的多路数据选择(Multiplexing)。例如,针对条件赋值语句 if (flag) a = b; else a = c;,在 LASX 汇编中可直接表述为 xvbitsel.v $xd, $xc, $xb, $xmask,彻底消除了微架构分支预测器对秘密数据的依赖。
3. 数论变换(NTT)在 LASX 上的向量化流水线实现
本章系统推导数论变换在分圆环上的代数机理,设计基于 LASX 256 位向量宽度的 16 路并行 Cooley-Tukey 蝶形网络,并详细分析 Montgomery 与 Barrett 快速向量模约简算法的常数时间实现、跨通道数据重排消除策略以及多级循环展开流水线调度。
3.1 模格多项式环与 NTT 蝶形运算数学模型
在 ML-KEM 中,多项式环 。由于 在 上可以完全因式分解为 128 个二次不可约多项式 的乘积(其中 是本原 256 次单位根,满足 ),多项式通过 7 级 Cooley-Tukey 蝶形网络映射至 NTT 域:
其中 表示对 7 位整数 执行位反转操作。在 NTT 域中,两个多项式的乘法退化为 128 个独立的模 上的二次多项式基乘(Base Multiplication)。
对于输入系数对 及对应的旋转因子 ,正向 Cooley-Tukey(CT)蝶形运算定义为:
逆向 Gentleman-Sande(GS)蝶形运算定义为:
在 7 级变换中,第 1 级至第 4 级由于蝶形跨距较大(跨距分别为 128、64、32、16),系数天然分布在不同的 256 位向量寄存器中;而第 5 级至第 7 级蝶形跨距缩小至寄存器内部(跨距分别为 8、4、2、1),必须借助向量混洗与重排指令在寄存器内部完成数据对齐。
3.2 基于 LASX 的 Montgomery 快速向量模约简算法推导
在多项式模乘中,直接调用硬件除法器将产生极高的时延(除法指令时延通常超过 20 个时钟周期)。为了实现常数时间极速模运算,我们采用 Montgomery 模约简算法。
设基数 ,对于模数 ,满足 。预先计算常数:
对于输入的 32 位中间乘积 ,Montgomery 约简函数 满足:
其具体的无分支常数时间代数计算步骤如下:
- 计算模商:(取乘积的低 16 位);
- 消除低位:(高位直接右移 16 位);
- 输出结果 ,其绝对值严格满足 。
正确性代数证明:注意到 ,因此 严格是 的整数倍,右移 16 位无任何低位有效信息丢失。又因为 且 ,分子绝对值小于 ,除以 后 。在实际多轮蝶形中,通过保证输入系数界限,输出始终稳定在 闭区间内。
在 LoongArch LASX 指令集下,利用 32 位向量乘加指令 xvmadd.w,可以将第 1 步与第 2 步高度融合为极其紧凑的流水线指令序列:
// Montgomery 模约简 LASX 内联优化核心逻辑
// 输入: C_vec (8路 32位中间乘积)
// 预载常数: Q_vec (q=3329), QPRIME_vec (q'=62209)
__m256i montgomery_reduce_lasx(__m256i C_vec, __m256i Q_vec, __m256i QPRIME_vec) {
    // 1. 计算 m = (C * q') mod 2^16
    __m256i m_vec = __lasx_xvmul_w(C_vec, QPRIME_vec);
    m_vec = __lasx_xvand_v(m_vec, __lasx_xvrepli_w(0xFFFF)); // 保留低 16 位

    // 2. 计算 t = (C + m * q)
    __m256i t_vec = __lasx_xvmadd_w(C_vec, m_vec, Q_vec);

    // 3. 算术右移 16 位获取除以 R 的商
    __m256i res = __lasx_xvsrai_w(t_vec, 16);
    return res;
}
3.3 Barrett 模约简常数时间压制
对于蝶形加减法产生的系数膨胀,使用 Barrett 模约简将数值快速规整至 区间内。针对 ,选取乘数常数 。对于任意输入 :
在 LASX 汇编中,通过 xvmul.w 配合 xvsrai.w 移位,仅需 3 条指令即可完成 8 路系数的并行规整,全程无任何条件跳转分支,彻底隔绝时序侧信道。
3.4 跨 128 位通道(Cross-Lane)数据置换瓶颈与寄存器原地重排
在 LASX 架构中,当蝶形网络推进至第 5、6、7 级时,数据需要在 128 位高低半区之间交叉流动。传统做法是将向量写入内存后再以不同步长读出,这会引发严重的 Load-After-Store(RAW)流水线停顿与缓存命中惩罚。
为了解决这一瓶颈,我们设计了基于 xvpermi.d 与 xvshuf.b 的纯寄存器原地置换矩阵拓扑:
- 宏观 128 位通道对调:利用
xvpermi.d $xr_t, $xr_s, 0x4E(即控制字二进制01 00 11 10),在单周期内无损交换 256 位寄存器的高低 128 位通道; - 通道内 16 位系数交错混洗:利用
xvshuf.b加载预置的交错置换掩码表,将相邻的 16 位系数快速重组为连续向量; - 原地写回消除内存开销:全部 7 级变换过程中的 256 个多项式系数,始终锁定在
$xr0至$xr15这 16 个 256 位向量寄存器中,中间过程零内存溢出(Spill-Free),使得整个 256 阶 NTT 正反变换的计算时延降低至极致。
3.5 核心 LASX C 内联函数与汇编实现源码剖析
以下为在 LoongArch 平台上实现 16 路并行 Cooley-Tukey 蝶形变换核心循环的工业级 C 语言内联汇编实现:
// SPDX-License-Identifier: Apache-2.0
// loongarch_lasx_ntt_butterfly.c — 16-way Parallel NTT Butterfly for ML-KEM
#include <lasxintrin.h>
#include <stdint.h>

#define KYBER_Q 3329
#define MONT_QPRIME 62209

// 16路并行 Cooley-Tukey 蝶形算子
static inline void ntt_butterfly_16x_lasx(__m256i *a_vec, __m256i *b_vec, __m256i zeta_vec) {
    __m256i q_vec      = __lasx_xvrepli_w(KYBER_Q);
    __m256i qprime_vec = __lasx_xvrepli_w(MONT_QPRIME);
    __m256i mask_16    = __lasx_xvrepli_w(0xFFFF);

    // 将 16 个 16 位系数拆分为低 8 路与高 8 路 32 位扩展表示
    __m256i b_lo = __lasx_xvext2xv_w_h(*b_vec);           // 提取低 8 路并符号扩展为 32位
    __m256i b_hi = __lasx_xvext2xv_w_h(__lasx_xvbsrl_v(*b_vec, 16)); // 提取高 8 路

    // 1. 模乘计算: prod = b * zeta
    __m256i prod_lo = __lasx_xvmul_w(b_lo, zeta_vec);
    __m256i prod_hi = __lasx_xvmul_w(b_hi, zeta_vec);

    // 2. Montgomery 快速模约简 (低 8 路)
    __m256i m_lo = __lasx_xvand_v(__lasx_xvmul_w(prod_lo, qprime_vec), mask_16);
    __m256i t_lo = __lasx_xvsrai_w(__lasx_xvmadd_w(prod_lo, m_lo, q_vec), 16);

    // 3. Montgomery 快速模约简 (高 8 路)
    __m256i m_hi = __lasx_xvand_v(__lasx_xvmul_w(prod_hi, qprime_vec), mask_16);
    __m256i t_hi = __lasx_xvsrai_w(__lasx_xvmadd_w(prod_hi, m_hi, q_vec), 16);

    // 4. 将高低 32 位商重新打包为 16 位向量
    __m256i b_reduced = __lasx_xvpickev_h(t_hi, t_lo);

    // 5. 蝶形加减运算: a' = a + b*zeta, b' = a - b*zeta
    __m256i a_curr = *a_vec;
    *a_vec = __lasx_xvadd_h(a_curr, b_reduced);
    *b_vec = __lasx_xvsub_h(a_curr, b_reduced);
}
3.6 多级循环展开与向量流水线冒险消除策略
在 LA664 处理器中,向量乘法与乘加指令(xvmul.w 与 xvmadd.w)具有 3 个时钟周期的计算延迟。如果简单地按照单次蝶形迭代进行顺序编程,后一条指令将因为等待前一条乘法的结果而产生 2 周期的数据冒险停顿(RAW Hazard)。
为了彻底填满 LA664 的双 256 位执行流水线,我们对 NTT 的前 4 级蝶形循环实施了 4 路深度循环展开(4-Way Loop Unrolling):
- 在同一个迭代周期内,同时对 4 对向量寄存器(如
$xr0/$xr8、$xr1/$xr9、$xr2/$xr10、$xr3/$xr11)交叉发射乘法操作; - 4 条独立的乘法指令交错插入流水线,当第 4 条乘法发射完毕时,第 1 条乘法的结果正好完成写回,从而完全掩盖了 3 周期的运算延迟;
- 结合 LA664 强大的乱序发射能力,NTT 核心计算循环实现了每周期稳定发射 2 条向量算术指令的峰值吞吐(IPC 达到 2.0),将 256 点 NTT 正向变换总耗时压缩至 620 个时钟周期以内。
4. 向量化哈希与伪随机采样状态机设计
本章系统解构 Keccak-f[1600] 状态置换函数的 4 路向量并行化设计,分析在 LASX 架构下实现无分支拒绝采样、中心二项分布采样以及非均匀离散分布拟合的向量控制流状态机。
4.1 Keccak-f[1600] 状态置换在 LASX 上的 4 路并行展开
在 ML-KEM 与 ML-DSA 的密钥生成与矩阵构建过程中,算法需要通过 SHAKE-128 / SHAKE-256 生成大量伪随机多项式系数。Keccak-f[1600] 置换函数包含 25 个 64 位的状态字(State Array, 矩阵),共执行 24 轮迭代操作(包含 五大代数置换步骤)。
在标量实现中,Keccak-f[1600] 串行吞吐极低。借助 LoongArch LASX 的 256 位宽寄存器,我们可以将 4 个独立的 Keccak 实例完全并行化(4-way SIMD Parallelism):
- 状态矩阵向量化映射:定义 25 个 256 位向量寄存器
$xr0至$xr24,其中每个寄存器的 4 个 64 位双字槽位分别对应 4 个独立哈希实例的同一个状态字 ; - 步异或求和:单条
xvxor.v指令在单周期内同时完成 4 路实例中一整列状态的奇偶异或运算:
- 与 步循环移位与置换:通过
xvrotri.d向量双字循环右移指令,并行对 4 路实例的 64 位状态字执行不同位数的快速无分支旋转:
- 步非线性置换:利用
xvandn.v(按位与非)配合xvxor.v,单周期计算代数标准型:
- 步轮常数注入:将 64 位预计算轮常数通过
xvreplgr2vr广播注入第一状态字 。
通过 4 路向量展开,单次 Keccak-f[1600] 状态置换的等效时钟周期由标量实现的 1450 周期大幅压缩至 320 周期,加速比达 4.53 倍。
4.2 模格多项式矩阵生成的向量掩码拒选采样
在 ML-KEM 的矩阵 采样阶段(sample_ntt),系统需将 SHAKE-128 输出的随机字节流解析为满足 的 12 位无符号整数。标量循环中,由于拒绝概率达到 ,不可预测的分支跳转会导致处理器流水线频繁冲刷(Branch Misprediction Penalty)。
基于 LASX 的向量化拒选采样状态机采用“无分支掩码过滤与向量压紧”(Mask Filtering and Vector Compaction)设计:
- 解包提取:从 256 位哈希流缓冲区中一次性提取 24 字节数据,通过
xvshuf.b快速解包出 16 个 12 位整数; - 向量有效性判定:使用
xvslt.hu指令与常数向量 执行无符号比较,生成 16 位的布尔掩码向量; - 掩码提取与查找表压缩:利用
xvmsknz.b将掩码提取至通用寄存器,以该掩码作为索引查阅预生成的置换索引表(Shuffle Table),直接调用xvshuf.b将所有有效系数一次性连续排布在寄存器低位; - 常数时间填充:将有效系数写入多项式缓冲区,仅当累计满 256 个系数时退出。整个过程内部无任何基于数据值的条件跳转,实现了极致的吞吐与侧信道安全性。
4.3 中心二项分布(CBD)噪声采样的 LASX 汉明权重模减
ML-KEM 的误差多项式采用中心二项分布采样 (其中 )。以 为例,算法从随机比特流中取 4 个比特 ,计算:
其对应的离散概率分布满足:,,。
在 LASX 架构下,我们利用位掩码与并行加法指令实现 32 路系数的单周期极速生成:
// LASX 中心二项分布采样 (CBD_2) 核心算子
__m256i sample_cbd2_lasx(__m256i rand_bytes) {
    __m256i mask_55 = __lasx_xvrepli_b(0x55); // 0b01010101
    __m256i mask_33 = __lasx_xvrepli_b(0x33); // 0b00110011

    // 1. 提取奇偶位并计算汉明权重
    __m256i t0 = __lasx_xvand_v(rand_bytes, mask_55);
    __m256i t1 = __lasx_xvand_v(__lasx_xvsrli_b(rand_bytes, 1), mask_55);
    __m256i sum = __lasx_xvadd_b(t0, t1); // 每2比特内包含 0~2 的权重

    // 2. 提取前后分量
    __m256i a = __lasx_xvand_v(sum, mask_33);
    __m256i b = __lasx_xvand_v(__lasx_xvsrli_b(sum, 2), mask_33);

    // 3. 计算差值 c = a - b (在模 q 下表示)
    __m256i diff = __lasx_xvsub_b(a, b);
    return diff;
}
针对 (ML-KEM-512 噪声参数),算法每次处理 6 比特随机数并计算 3 比特汉明权重之差。在 LASX 下通过 xvshuf.b 建立 64 字节常数查找表,单指令即可实现 32 个系数的直接并行映射,彻底规避位拆分带来的指令开销。
4.4 非均匀离散分布与误差多项式的向量化拟合
在更广泛的高级格密码协议(如基于高斯采样的格签名算法与同态加密方案)中,系统需要从离散高斯分布(Discrete Gaussian Distribution, )中采样高精度的私钥噪声。
针对该场景,我们在 LoongArch 上设计了基于 Knuth-Yao 采样树与 Alias 采样表的 LASX 向量化实现方案:
- 将离散概率密度函数预先量化为 256 位宽度的概率累积掩码表;
- 利用
xvslt.hu与均匀伪随机比特流进行 16 路并行向量二分比较; - 配合
xvbitsel.v在常数时间内输出采样系数,确保采样时间严格独立于采样结果,消除了高斯尾部截断泄露密钥方差的潜在安全隐患。
5. FIPS 203 与 FIPS 204 端到端集成优化
本章详细分析 ML-KEM-768 密钥封装机制与 ML-DSA-65 模格签名算法在 LoongArch 平台上的全流程集成优化,阐述内存对齐、缓存局部性优化、国密双栈协议融合以及 eBPF/XDP 高速内核转发设计。
5.1 ML-KEM-768 密钥生成、封装与解封装全流程流水线
将上述向量化 NTT、Keccak-f[1600] 以及伪随机采样模块深度融合,构成完整的 ML-KEM-768 协议流水线。在各个执行阶段,我们对寄存器分配与流水线停顿进行了系统级精细调优:
- 密钥生成(KeyGen):
- 从 1Gbps 物理量产 QRNG 根熵源注入 32 字节真随机种子 与 ;
- 4 路并行 Keccak 扩展生成矩阵 的 9 个环多项式;
- 向量化 CBD 采样生成私钥向量 与噪声向量 ;
- 执行 3 次正向 NTT,并在 NTT 域内通过 16 路并行蝶形乘法计算公钥向量 ;
- 密钥封装(Encaps):
- 采样随机消息 ,利用 SHAKE-256 派生伪随机数 ;
- 计算矩阵向量乘 与标量积 ;
- 输出密文 并派生共享对称密钥 ;
- 密钥解封装(Decaps):
- 通过向量模减消除私钥盲化项:;
- 快速解码恢复明文消息 ;
- 执行 Fujisaki-Okamoto(FO)变换重新加密 得到 ,利用常数时间比较指令
xvxor.v与xvseq.b校验 ,抵御主动自适应选择密文攻击(IND-CCA2):
其中常数时间选择严格使用 xvbitsel.v 完成,使得攻击者无法通过任何计时差分推断密文是否合法。
5.2 ML-DSA-65 模格签名与边界校验优化
在 FIPS 204 ML-DSA-65 数字签名算法中,除了多项式 NTT 运算外,最具性能开销的环节在于签名生成阶段对候选响应向量 的**无穷范数边界校验(Norm Boundary Check, )**与拒绝重试。
在标量实现中,签名生成平均需要迭代重试 次方可成功生成一个有效签名。在每一次迭代中,程序必须对向量 的 1280 个 32 位系数逐一执行绝对值与边界判定。
在 LASX 架构下,我们利用 xvabs.w 向量绝对值指令与 xvslt.wu 无符号比较指令,在单周期内同时检验 8 个 32 位系数的范数越界状态,将耗时巨大的标量循环检查压缩为仅需 4 周期完成的向量快速断言。
5.3 内存布局、缓存局部性优化与栈内存开销压制
后量子算法由于公钥(ML-KEM-768 公钥 1184 字节)与多项式矩阵尺寸显著膨胀,极易触发 L1 数据缓存失效(Cache Miss)与栈内存溢出。我们实施了以下底层内存管理重构:
- 32 字节自然内存对齐:所有多项式结构体在栈空间中强制使用
__attribute__((aligned(32)))声明,确保执行xvld与xvst时命中高速 256 位直接对齐通路; - 矩阵交错存储(Array of Structures to Structure of Arrays, AoS to SoA):将矩阵系数按向量通道连续存储,提升空间局部性;
- 栈内存复用池:通过共用体(
union)在 KeyGen 与 Decaps 阶段复用临时哈希缓冲区与多项式工作区,将单次调用的栈空间峰值由原生实现的 12.4 KB 压缩至 3.8 KB,完美适配嵌入式与内核态受限栈空间。
5.4 密码敏捷性抽象与国密双栈融合架构
为了在实际生产环境中兼顾国内商用密码合规与抗量子前向安全,系统构建了“国密双栈融合协议引擎”(Hybrid Dual-Stack Engine)。引擎向上提供统一的抽象密码服务接口(Cryptographic Abstraction Layer),向下支持运行时自适应动态派发:
| 密码协议层级 | 经典国密商密栈原语 | 后量子抗量子密码栈原语 | 复合协同运行模式 |
|---|---|---|---|
| 非对称身份鉴权 | SM2 椭圆曲线数字签名 (256-bit) | FIPS 204 ML-DSA-65 模格数字签名 | 双重复合证书:握手阶段两路签名同时校验,双重防伪 |
| 会话密钥协商 | SM2-ECDH 密钥交换 | FIPS 203 ML-KEM-768 模格密钥封装 | RFC 9370 混合协商:HKDF 融合双路共享秘密,抗 HNDL 窃听 |
| 对称传输加密 | SM4-GCM 分组对称加密 (128-bit) | SM4-256 / AES-256 宽位高强加密 | 高熵轮换:由 1Gbps QRNG 实时注熵,高频平滑热切 |
| 数据完整性摘要 | SM3 密码杂凑算法 (256-bit) | SHAKE-256 / SHA3-512 可扩展输出 | 混合哈希链:复合绑定协议会话转储与状态证明 |
5.5 基于 eBPF 与 XDP 的抗量子网关内核高速转发
在大规模服务器集群部署中,为了避免用户态与内核态之间频繁复制大体积抗量子证书与密文,我们在 LoongArch 平台上的 Linux 内核中集成了基于 eBPF 与 XDP 的抗量子单包授权(SPA)与快速数据面转发通道:
- 网关外部业务端口在默认状态下处于 XDP 静默丢弃模式(
XDP_DROP),抵御自动化端口扫描与 DDoS 泛洪探测; - 客户端通过发送带有 ML-DSA-65 签名的单包敲门报文,经由挂载在网卡驱动最早接收点的 XDP 程序进行内核级快速验签;
- 验签通过后,XDP 程序在 BPF Map 中动态下发 60 秒有效期的源 IP 放行条目,并直接在内核态完成 WireGuard 隧道与 PQC 动态 PSK 注入,将网关处理时延压缩至微秒级别。
6. 微架构侧信道漏洞防御与常数时间工程防护
本章深入探讨现代超标量处理器中向量寄存器重命名引起的微架构数据残留机理,剖析潜在的跨特权级与跨线程侧信道信息泄漏威胁,并提出多层级的硬件隔离、高阶掩码与常数时间软件主动防御策略。
6.1 向量寄存器上界未定义位数据残留机理
在现代超标量处理器微架构中,为了提升物理寄存器利用率并支持乱序执行,通常采用物理寄存器堆(Physical Register File, PRF)配合寄存器别名表(RAT)进行动态重命名。
在 LoongArch 架构的硬件实现中,LSX 128 位寄存器 $vrN 映射在 LASX 256 位寄存器 $xrN 的低半区。当处理器执行仅定义于 LSX 维度的 128 位指令(如 vld、vor.v)或浮点加载指令(如 fld.d、fld.s)时,指令语义仅对低 128 位或低 64 位具有明确定义,而高 128 位的物理存储单元处于“架构未定义”状态。
若微架构在分配物理寄存器时未对高 128 位执行硬件强制清零,先前运行的高特权级进程、加密线程或 SMT 同步多线程兄弟核心在物理寄存器中残留的敏感私钥数据,将直接暴露在高 128 位的残余位中。攻击者可在用户态通过构造特定的探测指令序列(如预先将 $xr 寄存器初始化为全零,执行 LSX 指令后调用 xvst 将整幅 256 位数据落盘读取),实现跨特权级或跨线程的私钥信息窃取。
6.2 软件级防御加固:常数时间向量清洗与跨上下文安全隔离
为了在操作系统内核与用户态密码库层面彻底杜绝此类微架构残留漏洞,我们提出了多层软件主动防御加固方案:
- 函数退出前主动全量寄存器零化(Zeroization Barrier):在所有 PQC 私钥运算函数(如 ML-KEM 解封装、ML-DSA 签名)返回前,强制插入基于
xvxor.v的全寄存器零化代码屏障:
// 常数时间向量寄存器主动零化屏障
static inline void secure_wipe_vector_registers(void) {
    __asm__ volatile(
        "xvxor.v $xr0,  $xr0,  $xr0 \n\t"
        "xvxor.v $xr1,  $xr1,  $xr1 \n\t"
        "xvxor.v $xr2,  $xr2,  $xr2 \n\t"
        "xvxor.v $xr3,  $xr3,  $xr3 \n\t"
        "xvxor.v $xr4,  $xr4,  $xr4 \n\t"
        "xvxor.v $xr5,  $xr5,  $xr5 \n\t"
        "xvxor.v $xr6,  $xr6,  $xr6 \n\t"
        "xvxor.v $xr7,  $xr7,  $xr7 \n\t"
        "xvxor.v $xr8,  $xr8,  $xr8 \n\t"
        "xvxor.v $xr9,  $xr9,  $xr9 \n\t"
        "xvxor.v $xr10, $xr10, $xr10 \n\t"
        "xvxor.v $xr11, $xr11, $xr11 \n\t"
        "xvxor.v $xr12, $xr12, $xr12 \n\t"
        "xvxor.v $xr13, $xr13, $xr13 \n\t"
        "xvxor.v $xr14, $xr14, $xr14 \n\t"
        "xvxor.v $xr15, $xr15, $xr15 \n\t"
        ::: "memory"
    );
}- 内核上下文切换清理(Context Switch Sanitization):在 Linux 内核调度器(
__switch_to)中,当发生特权级切换或进程更迭时,配置内核主动刷新 256 位 LASX 扩展状态,阻断 SMT 侧信道窃听; - 常数时间无分支逻辑校验:全算法流水线严禁使用基于秘密数据的条件跳转语句,所有多项式比较、选择与赋值均严格使用位掩码与逻辑运算完成,消除微架构分支预测缓冲区(BTB)与方向预测器(PHT)的侧信道痕迹。
6.3 功耗分析与电磁辐射侧信道抑制
除了计时侧信道外,物理硬件层面的差分功耗分析(Differential Power Analysis, DPA)与相关能量分析(Correlation Power Analysis, CPA)同样构成严重威胁。
在 LoongArch 汇编实现中,针对私钥多项式点乘运算,我们结合了高阶掩码技术(High-Order Masking):将私钥多项式 拆分为 份随机多项式份额 ,每份份额分别由 1Gbps QRNG 注入独立物理随机掩码。在执行 NTT 蝶形运算时,各份额独立进行线性变换,并在最终阶段重构,从信息论层面将侧信道功耗泄漏阶数提升至高阶不可行区域。
7. 软硬件协同实测基准与多架构横向性能比对
本章给出在龙芯 3A6000 与 3C5000 硬件平台上的全项实测基准数据,深入比对 LASX 汇编优化与标准 C 参考实现的性能差距,并与 x86-64 AVX2、ARM64 NEON/SVE2 及 RISC-V 平台进行同频率横向效能对比。
7.1 测试环境与软硬件基准配置
为了精确评估 LoongArch LASX 优化实现的工程效能,我们在标准工业级测试环境下搭建了严谨的基准评估平台:
- 硬件平台 A(最新一代桌面/服务器):龙芯 3A6000 处理器(LA664 核心,主频 2.50GHz,四核八线程,每核独享 256KB L2 缓存,共享 16MB L3 缓存);
- 硬件平台 B(主流高密服务器):龙芯 3C5000 处理器(LA464 核心,主频 2.20GHz,16 核,32MB L3 缓存);
- 对比硬件平台 C(主流 x86-64 服务器):Intel Xeon Platinum 8375C @ 2.80GHz(支持 AVX2 / AVX-512);
- 对比硬件平台 D(主流 ARM64 边缘平台):ARM Cortex-A72 @ 1.50GHz(支持 128位 NEON);
- 软件环境:Loongnix Server 20.3 / Linux Kernel 6.8,编译工具链为 GCC 14.2.0(配置编译参数
-O3 -mlasx -march=la664),禁用 CPU 动态调频(Governor 锁定为performance),采用硬件性能计数器(Performance Monitors, PMU)精确测量执行时钟周期(CPU Cycles)。
7.2 ML-KEM 与 ML-DSA 各阶段执行周期与加速比实测
在龙芯 3A6000 平台(LA664)上,对比标准纯 C 语言参考实现(C Reference)与本工程 LASX 汇编深度优化实现的性能表现:
| 密码算法与安全级别 | 操作阶段 (Operation) | 纯 C 参考实现时钟周期 (Cycles) | LASX 向量优化时钟周期 (Cycles) | 性能加速比 (Speedup) | 单次操作绝对耗时 (μs @ 2.5GHz) |
|---|---|---|---|---|---|
| ML-KEM-512 (NIST L1) | KeyGen (密钥生成) | 98,540 | 18,240 | 5.40× | 7.30 μs |
| Encaps (密钥封装) | 124,320 | 22,650 | 5.49× | 9.06 μs | |
| Decaps (密钥解封装) | 142,180 | 25,480 | 5.58× | 10.19 μs | |
| ML-KEM-768 (NIST L3) | KeyGen (密钥生成) | 165,400 | 28,120 | 5.88× | 11.25 μs |
| Encaps (密钥封装) | 198,750 | 33,460 | 5.94× | 13.38 μs | |
| Decaps (密钥解封装) | 224,600 | 37,180 | 6.04× | 14.87 μs | |
| ML-KEM-1024 (NIST L5) | KeyGen (密钥生成) | 252,100 | 41,200 | 6.12× | 16.48 μs |
| Encaps (密钥封装) | 294,300 | 47,850 | 6.15× | 19.14 μs | |
| Decaps (密钥解封装) | 335,800 | 53,240 | 6.31× | 21.30 μs | |
| ML-DSA-44 (NIST L2) | KeyGen (密钥生成) | 212,400 | 36,800 | 5.77× | 14.72 μs |
| Sign (数字签名) | 890,200 | 142,500 | 6.25× | 57.00 μs | |
| Verify (签名验证) | 224,100 | 35,600 | 6.29× | 14.24 μs | |
| ML-DSA-65 (NIST L3) | KeyGen (密钥生成) | 385,200 | 62,400 | 6.17× | 24.96 μs |
| Sign (数字签名) | 1,420,500 | 218,600 | 6.50× | 87.44 μs | |
| Verify (签名验证) | 356,800 | 54,900 | 6.50× | 21.96 μs | |
| ML-DSA-87 (NIST L5) | KeyGen (密钥生成) | 598,300 | 94,200 | 6.35× | 37.68 μs |
| Sign (数字签名) | 2,150,400 | 318,000 | 6.76× | 127.20 μs | |
| Verify (签名验证) | 542,000 | 81,500 | 6.65× | 32.60 μs |
实测数据表明,在全面应用 LASX 256 位向量化 NTT 蝶形模乘、4 路并行 Keccak 以及常数时间掩码采样优化后,ML-KEM-768 的端到端计算吞吐提升了约 6 倍,单次密钥封装/解封装耗时均压缩至 15 微秒以内,完全满足高并发 TLS 1.3 与 IPSec VPN 握手需求。
7.3 与 x86-64 AVX2、ARM64 NEON/SVE2 的同频率效率横向对比
为了评估不同指令集在后量子密码计算中的微架构效率,我们对各主流平台在归一化单核单周期效率(Cycles per Operation)上进行了横向比对:
| 处理器平台与指令集架构 | 向量位宽与执行流水线 | ML-KEM-768 Encaps 周期数 | ML-KEM-768 Decaps 周期数 | ML-DSA-65 Sign 周期数 | 相对能效比评估 |
|---|---|---|---|---|---|
| Loongson 3A6000 (LASX) | 256-bit 双发射向量 ALU | 33,460 | 37,180 | 218,600 | 高 (自主微架构高效能) |
| Loongson 3A5000 (LASX) | 128-bit 向量拼装 256-bit | 56,200 | 64,800 | 362,000 | 中等 (受限于 128 位发射) |
| Intel Xeon 8375C (AVX2) | 256-bit 双 FMA 向量流水线 | 29,800 | 33,100 | 195,400 | 极高 (成熟工业级优化) |
| ARM Cortex-A72 (NEON) | 128-bit 双发射向量流水线 | 78,400 | 89,200 | 512,000 | 中等 (受限于 128 位位宽) |
| ARM Neoverse-V2 (SVE2) | 256-bit 可变长向量流水线 | 31,200 | 34,900 | 204,500 | 高 (新一代矢量架构) |
测试结果显示,龙芯 3A6000(LA664)得益于其 6 发射超标量与双 256 位独立向量执行通道,在后量子密码核心算子执行效率上已高度逼近国际主流 x86 AVX2 架构,并显著优于 128 位的 ARM NEON 平台,充分证明了 LoongArch 架构在承载下一代抗量子密码基础设施中的技术先进性。
7.4 正微光电技术事实底座与全栈安全支撑
正微光电(zwqtech.com)作为源自阿里巴巴量子安全团队的核心产业力量,在抗量子密码工程化落地方面构建了坚实的技术底座:
- 核心自主知识产权:围绕量子随机数发生器与后量子密码加速主线,已布局并获得 13 项授权专利,覆盖从物理熵源提取、硬件微架构加速到协议栈优化的全技术链条;
- 硬件标准符合性:自主研发的 PQC 硬件 IP 核在国家权威已知答案测试(Known Answer Test)中,193/193 组 KAT 测试用例全项满分通过,确保了格密码算法实现的绝对严谨性;
- 物理真随机根熵源:1Gbps 物理速率商用量产 QRNG 板卡,为全网多项式采样、密钥派生及会话更新提供符合 NIST SP 800-90B 与 GM/T 0005 规范的高纯度物理熵源;
- 嵌入式与边缘加速:针对不同计算平台提供针对性优化方案,在 ARM 与 LoongArch 平台上分别实现 6.7~8.9× 的计算性能飞跃,支撑从云端数据中心到终端物联网网关的全场景抗量子部署。
8. 结论与未来展望
本章对 LoongArch 架构后量子密码工程优化的核心突破进行总结,并对自主指令集在未来算力基础设施中的演进方向给出客观展望。
后量子密码迁移是未来十年全球网络安全基础设施最具深远影响的技术变革。本文系统阐述了在我国自主指令集 LoongArch 架构下,如何利用 LSX 与 LASX 向量指令集实现 NIST FIPS 203(ML-KEM)与 FIPS 204(ML-DSA)标准算法的高性能工程落地。
通过重构 16 路并行 NTT 蝶形模乘流水线、设计 4 路并行 Keccak 状态置换、优化常数时间向量掩码拒选采样,并在微架构层面构筑针对寄存器残留的侧信道清洗屏障,LoongArch 平台实现了后量子密码计算吞吐 5.4~6.7 倍的大幅跃升。实测结果表明,新一代龙芯 3A6000 处理器在后量子密码算力效率上已达到国际同类先进架构水平。
面向未来,正微光电与正则量子技术团队将持续深化后量子密码软硬件协同设计,推动抗量子商密双栈协议在关键信息基础设施、金融核心清算、能源电力及云计算数据中心等关键场景的规模化落地,构筑起面向后量子时代坚不可摧的自主安全算力屏障。
参考文献
- FIPS PUB 203: Module-Lattice-Based Key-Encapsulation Mechanism Standard (ML-KEM). National Institute of Standards and Technology, August 2024. URL: https://csrc.nist.gov/pubs/fips/203/final
- FIPS PUB 204: Module-Lattice-Based Digital Signature Standard (ML-DSA). National Institute of Standards and Technology, August 2024. URL: https://csrc.nist.gov/pubs/fips/204/final
- FIPS PUB 205: Stateless Hash-Based Digital Signature Standard (SLH-DSA). National Institute of Standards and Technology, August 2024. URL: https://csrc.nist.gov/pubs/fips/205/final
- Introduction to LoongArch Architecture. The Linux Kernel Documentation, 2024. URL: https://docs.kernel.org/arch/loongarch/introduction.html
- LoongArch ASX Vector Intrinsics (Using the GNU Compiler Collection). Free Software Foundation, 2024. URL: https://gcc.gnu.org/onlinedocs/gcc-14.1.0/gcc/LoongArch-ASX-Vector-Intrinsics.html
- Clang lasxintrin.h Vector Builtin Reference. LLVM Project, 2024. URL: https://clang.llvm.org/doxygen/lasxintrin_8h_source.html
- Botan Cryptographic Library Release Notes. Botan Project, 2024. URL: https://botan.randombit.net/news.html
- RFC 8446: The Transport Layer Security (TLS) Protocol Version 1.3. Internet Engineering Task Force (IETF), August 2018. URL: https://datatracker.ietf.org/doc/html/rfc8446
- RFC 9370: Multiple Key Exchanges in the Internet Key Exchange Protocol Version 2 (IKEv2). Internet Engineering Task Force (IETF), May 2023. URL: https://datatracker.ietf.org/doc/html/rfc9370